Python 3. Строки
Свойства строк
Я уже писал про последовательности и множества в Python 3. Строка — это неизменяемая последовательность символов, которая используется для хранения текстовой информации.
Строки в Python 3 записываются в одинарных или двойных кавычках. Строка объект класса str, и у этого объекта есть идентификатор (id). Ещё одним свойством строки является её длина.
Код:
my_str = "Привет, мир!"
print(type(my_str))
print(id(my_str))
print(len(my_str))
Исполнение:
<class 'str'>
1817049462416
12
Функция type возвращает тип объекта, id — его идентификатор (в CPython это адрес объекта в памяти), а len — количество символов в строке. Число, которое выведет id, у вас будет другим, оно меняется при каждом запуске программы.
Строки неизменяемы
Объект "Привет, мир!" изменить нельзя, так как строковый тип в Python 3 считается неизменяемым. Это означает, что мы можем создать другую строку и связать её с переменной my_str, но другая строка уже будет другим объектом (с другим идентификатором). Это видно в следующем примере.
Код:
my_str = "Привет, мир!"
print(id(my_str))
my_str = "Привет, мир!!!"
print(id(my_str))
Исполнение:
1632988001936
1632989959136
Если попытаться изменить отдельный символ строки, то получим ошибку.
Код:
my_str = "Привет, мир!"
my_str[0] = 'п'
Исполнение:
TypeError: 'str' object does not support item assignment
Это важный момент, который нужно запомнить: все методы строк не меняют исходную строку, а возвращают новую.
Код:
my_str = 'Привет'
my_str.upper()          # Результат никуда не сохранили
print(my_str)

my_str = my_str.upper() # Привязали новую строку к переменной
print(my_str)
Исполнение:
Привет
ПРИВЕТ
Первый вызов upper() создал строку 'ПРИВЕТ', но мы её никуда не записали, поэтому она сразу была потеряна. Это одна из самых частых ошибок у новичков.
Создание строк
Строку можно создать несколькими способами. Самый простой — записать текст в кавычках. Одинарные и двойные кавычки равнозначны, и выбор между ними нужен для удобства. Например, если внутри текста есть кавычки одного вида, то саму строку можно записать кавычками другого вида:
Код:
print("Это 'одинарные' кавычки внутри двойных")
print('Это "двойные" кавычки внутри одинарных')
Исполнение:
Это 'одинарные' кавычки внутри двойных
Это "двойные" кавычки внутри одинарных
Если нужно написать многострочный текст, то используйте тройные кавычки (одинарные или двойные).
Код:
text = """Первая строка
Вторая строка
Третья строка"""
print(text)
Исполнение:
Первая строка
Вторая строка
Третья строка
Также строку можно получить из объекта другого типа с помощью функции str.
Код:
num = 2026
my_str = str(num)
print(my_str, type(my_str))
Исполнение:
2026 <class 'str'>
А пустая строка создаётся просто двумя кавычками: ''.
Индексация строк
Строки индексируются, причём двумя способами:
- слева направо, начиная с 0;
- справа налево, начиная с -1.
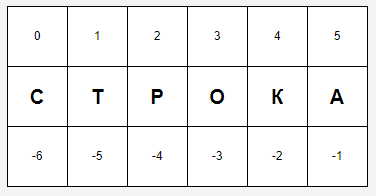
Это позволяет обращаться к символам в строке по индексу (положительному или отрицательному), а также создавать срезы строк.
Код:
my_str = 'Привет, Мир!'
print(my_str[0])      # Первый символ
print(my_str[-1])     # Последний символ
print(my_str[0:3])    # Срез с 0 элемента по 3 не включительно
print(my_str[0:6])    # Срез с 0 элемента по 6 не включительно
print(my_str[0:6:2])  # Срез с 0 элемента по 6 не включительно, с шагом 2
Исполнение:
П
!
При
Привет
Пие
Запомните: когда вы указываете срез, то указываете, от какого элемента (включительно) и до какого элемента (не включительно). А также вы можете указать шаг среза, например каждый второй элемент или каждый третий, и так далее.
Начало и конец среза можно не указывать, тогда срез пойдёт от начала или до конца строки.
Код:
my_str = 'Привет, Мир!'
print(my_str[:6])     # С начала до 6 элемента не включительно
print(my_str[8:])     # С 8 элемента и до конца
print(my_str[-4:])    # Последние 4 символа
print(my_str[::-1])   # Вся строка задом наперёд (шаг -1)
Исполнение:
Привет
Мир!
Мир!
!риМ ,тевирП
Если обратиться к несуществующему индексу, то получим ошибку IndexError. А вот срез за границами строки ошибки не вызовет, просто вернётся то, что есть.
Код:
my_str = 'Привет'
print(my_str[1:100])
print(my_str[100])
Исполнение:
ривет
IndexError: string index out of range
Базовые операции со строками
Объединение (конкатенация) строк выполняется с помощью оператора +.
Код:
str1 = "Привет,"
str2 = " мир!"
print(str1 + str2)
Исполнение:
Привет, мир!
Складывать можно только строки со строками. Если попытаться сложить строку с числом, то получим ошибку, и число нужно предварительно превратить в строку.
Код:
print("Год: " + 2026)
Исполнение:
TypeError: can only concatenate str (not "int") to str
Код:
print("Год: " + str(2026))
Исполнение:
Год: 2026
Повторение строк выполняется с помощью оператора *.
Код:
str1 = "Привет"
print(str1 * 3)
Исполнение:
ПриветПриветПривет
При повторении строк умножать можно только на целое число. При этом, если умножить на 0 или отрицательное число, то получим пустую строку.
Проверить, входит ли одна строка в другую, можно с помощью операторов in и not in. Результатом будет True или False.
Код:
str1 = "Привет"
print('При' in str1)
print('Маш' in str1)
print('Маш' not in str1)
Исполнение:
True
False
True
Важно помнить, что сравнение строк чувствительно к регистру: 'привет' == 'Привет' вернёт False.
Спецсимволы и сырые строки
В строках можно использовать специальные символы (их ещё называют экранированными последовательностями). Они начинаются с обратной косой черты. Самые популярные:
\n— перевод строки;\t— табуляция;\\— сам символ обратной косой черты;\'и\"— кавычки внутри строки.
Код:
print('Привет\tМир!')
print('Привет\nМир!')
print('Это обратная косая: \\')
print('It\'s a string')
Исполнение:
Привет  Мир!
Привет
Мир!
Это обратная косая: \
It's a string
Кстати, в этих примерах я не создавал переменную, как в предыдущих. Функция print умеет выводить значения любых типов, не только строки.
Со спецсимволами есть одна неприятность, о которой знают все, кто работает с Windows. В путях используется обратная косая черта, и Python может принять её за начало спецсимвола.
Код:
print('C:\new\table')
Исполнение:
C:
ew      able
Python увидел \n и \t и превратил их в перевод строки и табуляцию. Чтобы такого не происходило, используйте сырые строки (raw strings). Для этого перед открывающей кавычкой ставится буква r, и тогда обратная косая черта воспринимается как обычный символ.
Код:
print(r'C:\new\table')
Исполнение:
C:\new\table
Но есть нюанс: сырая строка не может заканчиваться одиночной обратной косой чертой, то есть r'C:\temp\' вызовет ошибку.
Методы строк
У строк есть много встроенных методов. Методы вызываются через точку после объекта: строка.метод(). Напомню, что они возвращают новую строку (или другое значение), а исходную не меняют.
Регистр
Перевести строку в верхний или в нижний регистр можно с помощью методов upper и lower.
Код:
my_str = 'Привет'
print(my_str.upper())
print(my_str.lower())
Исполнение:
ПРИВЕТ
привет
Также есть метод capitalize (первая буква заглавная, остальные строчные) и title (каждое слово с заглавной буквы).
Код:
my_str = 'привет мир'
print(my_str.capitalize())
print(my_str.title())
Исполнение:
Привет мир
Привет Мир
Поиск
Метод find ищет подстроку и возвращает индекс первого совпадения. Если подстроки нет, вернётся -1.
Код:
my_str = 'Привет'
print(my_str.find('вет'))
print(my_str.find('Маш'))
Исполнение:
3
-1
Есть похожий метод index, но если подстрока не найдена, он вызывает ошибку ValueError.
Код:
my_str = 'Привет'
print(my_str.index('Маш'))
Исполнение:
ValueError: substring not found
Посчитать, сколько раз подстрока встречается в строке, можно методом count.
Код:
my_str = 'мама мыла раму'
print(my_str.count('м'))
Исполнение:
4
Проверить, с чего начинается или чем заканчивается строка, можно методами startswith и endswith. Они удобны, например, при работе с именами файлов или хостов.
Код:
file_name = 'backup_2026.tar.gz'
print(file_name.startswith('backup'))
print(file_name.endswith('.gz'))
Исполнение:
True
True
Замена
Можем в строке заменить подстроку на другую подстроку с помощью метода replace.
Код:
str1 = "Привет"
print(str1.replace('вет', 'манка'))
Исполнение:
Приманка
По умолчанию заменяются все совпадения. Если нужно заменить только первые несколько, третьим аргументом указывается их количество.
Код:
str1 = "a-b-c-d"
print(str1.replace('-', '_'))
print(str1.replace('-', '_', 2))
Исполнение:
a_b_c_d
a_b_c-d
Удаление лишних символов
Методы lstrip, rstrip и strip удаляют символы с левой стороны, с правой стороны или с обеих сторон. Если вызвать их без аргументов, то они удалят пробельные символы (пробелы, табуляции, переводы строк).
Код:
my_str = '  Привет Мир!  \n'
print(repr(my_str.strip()))
Исполнение:
'Привет Мир!'
Здесь я использовал функцию repr, чтобы увидеть строку вместе с кавычками и спецсимволами.
Если передать аргумент, то методы удалят указанные символы. Аргумент — это не подстрока, а набор символов. Методы удаляют с края строки все символы, которые входят в этот набор, пока не встретят символ, которого в наборе нет.
Код:
my_str = '---Привет Мир---'
print(my_str.strip('-'))

file_name = 'test.txt'
print(file_name.rstrip('.txt'))
Исполнение:
Привет Мир
tes
Мы хотели убрать расширение .txt и получить test, а получили tes. Метод удалил с правого края все символы из набора ., t, x, и последняя буква t в слове test тоже попала под удаление.
Если нужно удалить именно подстроку (приставку или окончание), то начиная с Python 3.9 для этого есть методы removeprefix и removesuffix.
Код:
file_name = 'test.txt'
print(file_name.removesuffix('.txt'))

my_str = 'Привет Мир!'
print(my_str.removeprefix('Привет '))
Исполнение:
test
Мир!
Разбиение и объединение
Строку можно разбить по разделителю в список подстрок с помощью метода split.
Код:
str1 = "Один, два, три"
print(str1.split(','))
print(str1.split(', '))
Исполнение:
['Один', ' два', ' три']
['Один', 'два', 'три']
В первом случае разделителем была только запятая, поэтому пробелы остались в начале подстрок. Во втором разделитель ', ' (запятая с пробелом) и лишних пробелов нет.
Если вызвать split без аргументов, то строка разобьётся по любым пробельным символам, причём несколько пробелов подряд считаются одним разделителем.
Код:
str1 = "один   два\tтри\nчетыре"
print(str1.split())
Исполнение:
['один', 'два', 'три', 'четыре']
Вторым аргументом можно указать максимум разрезов. Это удобно, например, при разборе строк из файла /etc/passwd.
Код:
line = 'root:x:0:0:root:/root:/bin/bash'
print(line.split(':'))
print(line.split(':', 1))
- Один разрез, означает две части.
Исполнение:
['root', 'x', '0', '0', 'root', '/root', '/bin/bash']
['root', 'x:0:0:root:/root:/bin/bash']
Обратная операция — join. Она склеивает элементы списка в одну строку. Синтаксис немного неудобный: 'разделитель'.join(список).
Код:
my_list = ['Один', 'два', 'три']
print(', '.join(my_list))
print('-'.join(my_list))
Исполнение:
Один, два, три
Один-два-три
Обратите внимание, что join работает только со строками. Если в списке окажется число, то будет ошибка TypeError, и такой элемент сначала нужно превратить в строку через str.
Преобразование строки в список
Также можем конвертировать строку в список символов с помощью функции list.
Код:
my_str = 'Привет'
my_list = list(my_str)
print(my_list)
Исполнение:
['П', 'р', 'и', 'в', 'е', 'т']
Это удобно, когда нужно «изменить» строку: превращаем её в список, меняем нужный элемент, а потом склеиваем обратно с помощью join.
Код:
my_list = list('Привет')
my_list[0] = 'п'
print(''.join(my_list))
Исполнение:
привет
Проверка содержимого
Есть методы, которые проверяют, из чего состоит строка, и возвращают True или False.
Код:
print('2026'.isdigit())      # Только цифры
print('Привет'.isalpha())    # Только буквы
print('Привет1'.isalpha())
print('привет'.islower())    # Все буквы строчные
Исполнение:
True
True
False
True
Комбинирование методов
Методы и срезы можно комбинировать. Например, выведем срез строки заглавными буквами.
Код:
my_str = 'Привет, Мир!'
print(my_str[:6].upper())
Исполнение:
ПРИВЕТ
Методы можно вызывать цепочкой, и каждый следующий работает с результатом предыдущего.
Код
my_str = '  привет мир  '
print(my_str.strip().title())
Исполнение:
Привет Мир
Форматирование строк
Часто нужно вставить значения переменных внутрь текста. Конкатенация с + получается громоздкой, да ещё и числа приходится превращать в строки. Поэтому в современном Python используют f-строки (доступны с Python 3.6). Перед открывающей кавычкой ставится буква f, а переменные пишутся в фигурных скобках прямо внутри текста.
Код:
host = 'pve01'
cpu = 37.5
print(f'Хост {host}: загрузка CPU {cpu}%')
Исполнение:
Хост pve01: загрузка CPU 37.5%
Внутри фигурных скобок можно писать не только имена переменных, но и любые выражения.
Код:
a = 5
b = 3
print(f'{a} + {b} = {a + b}')
Исполнение:
5 + 3 = 8
После двоеточия можно указать формат вывода.
Код:
cpu = 37.56789
size = 1234567
print(f'{cpu:.1f}')     # Одна цифра после запятой
print(f'{size:,}')      # Разделитель тысяч
print(f'{5:03}')        # Ширина 3, добивка нулями
Исполнение:
37.6
1,234,567
005
А если добавить знак равенства, то f-строка выведет и имя переменной, и её значение. Это удобно при отладке.
Код:
host = 'pve01'
print(f'{host=}')
Исполнение:
host='pve01'
Внутри f-строки нужно следить за кавычками. До Python 3.12 нельзя было использовать внутри фигурных скобок такие же кавычки, какими обрамлена вся строка. Начиная с Python 3.12 это ограничение убрали.
Код:
user = {'name': 'Александр'}
print(f"Привет, {user["name"]}!")   # Работает только в Python 3.12 и новее
Исполнение:
Привет, Александр!
Если у вас версия старше, то используйте разные кавычки: f"Привет, {user['name']}!".
Также в старом коде вы можете встретить другие способы форматирования: метод format ('Привет, {}!'.format(name)) и оператор % ('Привет, %s!' % name). Они работают до сих пор, но в новом коде лучше использовать f-строки.
В Python 3.14 появился ещё один вид строк — t-строки (template strings). Они выглядят как f-строки, но с буквой t, и возвращают не готовую строку, а специальный объект шаблона. Это нужно, например, для безопасной подстановки данных в SQL-запросы или HTML. Для повседневных задач хватает f-строк, поэтому подробно разбирать t-строки я здесь не буду.
Строки и кодировки
В Python 3 строки хранятся в Unicode. Это значит, что в строке могут быть символы любых языков и даже эмодзи, и функция len считает именно символы, а не байты.
Но на диске и в сети хранятся не символы, а байты. Чтобы превратить строку в байты, используется метод encode, а чтобы вернуть обратно — метод decode. Нужно указать кодировку, чаще всего это utf-8.
Код:
my_str = 'Привет'
my_bytes = my_str.encode('utf-8')

print(my_bytes)
print(len(my_str), len(my_bytes))
print(my_bytes.decode('utf-8'))
Исполнение:
b'\xd0\x9f\xd1\x80\xd0\xb8\xd0\xb2\xd0\xb5\xd1\x82'
6 12
Привет
В строке 6 символов, а в байтах 12, потому что в UTF-8 каждая русская буква занимает 2 байта.
Если декодировать байты не той кодировкой, в которой они были получены, то получим ошибку или «кракозябры». С таким часто сталкиваются при работе с Windows-файлами, где может быть кодировка cp1251.
Код:
my_bytes = 'Привет'.encode('cp1251')
print(my_bytes)
print(my_bytes.decode('cp1251'))
Исполнение:
b'\xcf\xf0\xe8\xe2\xe5\xf2'
Привет
Поэтому при чтении и записи файлов лучше всегда явно указывать кодировку, например open('file.txt', encoding='utf-8').
Шпаргалка
| Что нужно сделать | Как сделать |
|---|---|
| Узнать длину | len(s) |
| Взять символ / срез | s[0], s[-1], s[1:4], s[::-1] |
| Объединить / повторить | s1 + s2, s * 3 |
| Проверить вхождение | 'ab' in s |
| Регистр | upper(), lower(), title() |
| Найти подстроку | find(), index(), count() |
| Начало / конец строки | startswith(), endswith() |
| Заменить | replace(old, new) |
| Убрать пробелы по краям | strip(), lstrip(), rstrip() |
| Убрать приставку / окончание | removeprefix(), removesuffix() |
| Разбить / склеить | split(), 'sep'.join(list) |
| Вставить значения в текст | f'{var}' |
| Строка ↔ байты | encode('utf-8'), decode('utf-8') |
Если понравилась статья, подпишись на мой канал в VK или Telegram .